虚拟内存页经过 MoE Router 分发到专家池与异构设备的科研示意图

SYSTEMS RESEARCH · PROJ 59 · SYSU

小内存,
也能承载大模型

以虚拟内存为数据平面,以 MoE 稀疏性为调度信号,构建跨越 WSL、Apple Silicon、RK3588、Raspberry Pi 与 Ascend 的端侧推理运行时。

Mac / 2 GiB / no-swap
48.41 GB 80B 模型完成推理
RK3588 / 3 GiB
Decode 0.70 → 2.21 tok/s
WSL / 32 GiB / warm
FlashAttention 3.01 → 5.16 tok/s
向下阅读
01 / RESEARCH QUESTION

当模型规模超越设备内存

80B 级 MoE 的模型文件远大于常见端侧内存,但每个 token 实际只激活极少数专家。问题不是把全部参数塞进内存,而是让正确的页在正确的阶段及时到达。

01

权重访问具有阶段性

Prefill 偏向连续扫描,Decode 偏向复用与稀疏访问。固定页建议会在不同设备上产生相反结果。

02

专家命中率不是最终目标

预取正确仍可能付出过高 I/O 成本;运行时必须同时约束预测、回收、驻留与预算。

03

跨设备需要策略而非常数

NVMe、虚拟磁盘、SSD 与 FUSE/USB 的同步缺页代价不同,统一机制必须允许设备化选择。

02 / MEMORY-AWARE RUNTIME

让 Router 反馈进入操作系统路径

SLIM-ARC 把模型阶段、专家事实与 cgroup 压力连接成一个闭环。页建议不再是静态开关,而是由当前工作负载和设备状态共同决定。

  1. 01

    页粒度权重访问

    mmap 按需加载、阶段化 SEQUENTIAL/NORMAL 与有界 readahead。

  2. 02

    专家预测、结算与回收

    Temporal 与 cross-layer Router 候选在事实返回后按 generation 精确结算。

  3. 03

    压力自适应驻留

    以 cgroup headroom、热度和 waste EWMA 约束专家集合与 I/O 预算。

  4. 04

    KV 与算子协同

    滑动窗口、KV 量化与 FlashAttention 根据上下文和内存余量组合。
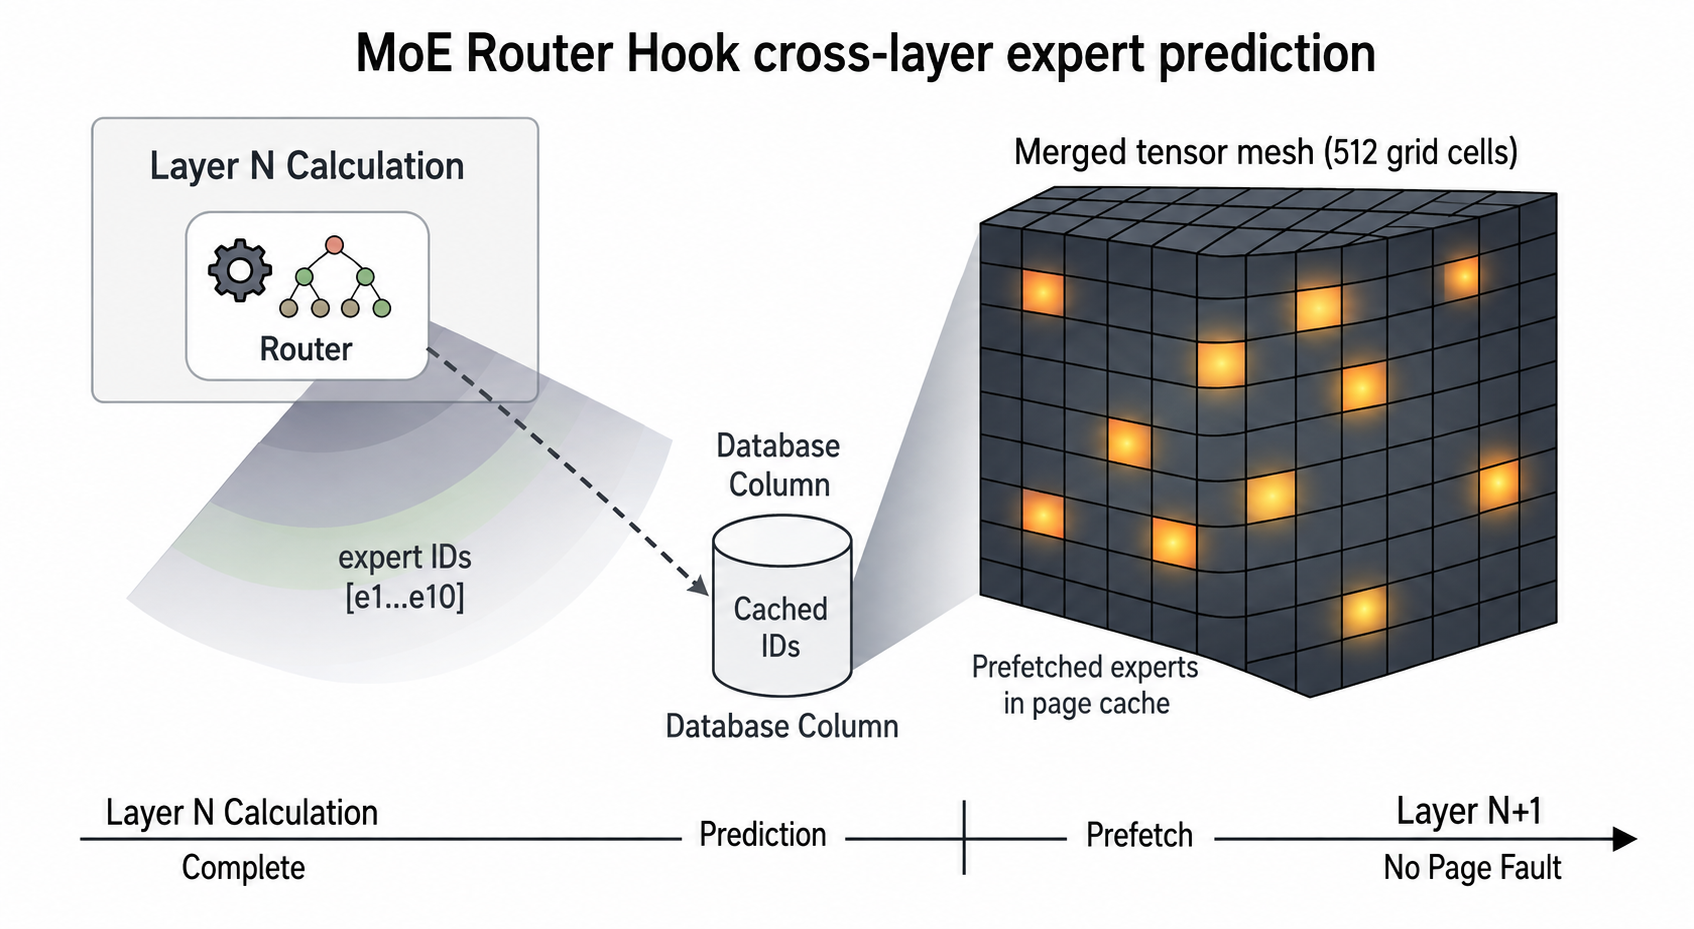
MoE Router 跨层专家预测与页缓存预取闭环
专家管理闭环。 预测只负责提出候选;实际 Router 结果负责结算;错误页回收和驻留更新在有限预算内完成。
Model-owned lifecycle运行时与模型映射同生共死,图执行只持有安全 lease。
Generation settlement每次预取都携带不可复用 token,成功、失败与空结果均可终结。
Opt-in policies新机制保留回退路径;组合策略必须在同合同下重新验证。

03 / EDGE EVIDENCE ATLAS

跨设备证据地图

数据不跨设备相乘,也不把 cold 与 warm 混为一谈。每个结论都绑定模型、缓存状态、内存限制和 workload。

平台与合同 约束 核心结果 结论
WSL / x86Qwen3-Next-80B
8 GiB · pp4/tg1
0.08 → 0.43Decode tok/s
强约束下页管理改善 Decode;同合同提升 437.5%
Mac / Colima80B Q4_K_M · 48.41 GB
2 GiB · 4 vCPU · swap 0
3.908 / 0.709Prefill / Decode tok/s
模型文件为内存上限 24.2 倍,终态运行成功
RK358880B · pp128/tg64
3 GiB · 4 threads · swap 0
0.70 → 2.21Decode tok/s · 3.16×
受限越强收益越明显;Prefill 同时提高 14%
Raspberry Pi 580B · USB/FUSE 慢存储
4 GiB · no-swap
+14.16%shared/hot Decode
驻留确定复用页,并以 16 MiB 预算削减 98.44% 投机 I/O
Ascend 910B4OLMoE Q2_K · aarch64
llama.cpp CPU-only
系统 A/B 跑通NPU 路径未宣称加速
验证 POSIX/aarch64 可移植性,并明确 CANN 工具链边界

完整实验包含原始日志、结构化 JSON、缓存状态、cgroup 指标和版本身份;负面结果同样保留,用于确定策略适用范围。

阅读 41 页完整评测与附录

04 / BOUNDARIES MATTER

极致性能来自选择,而不是堆叠

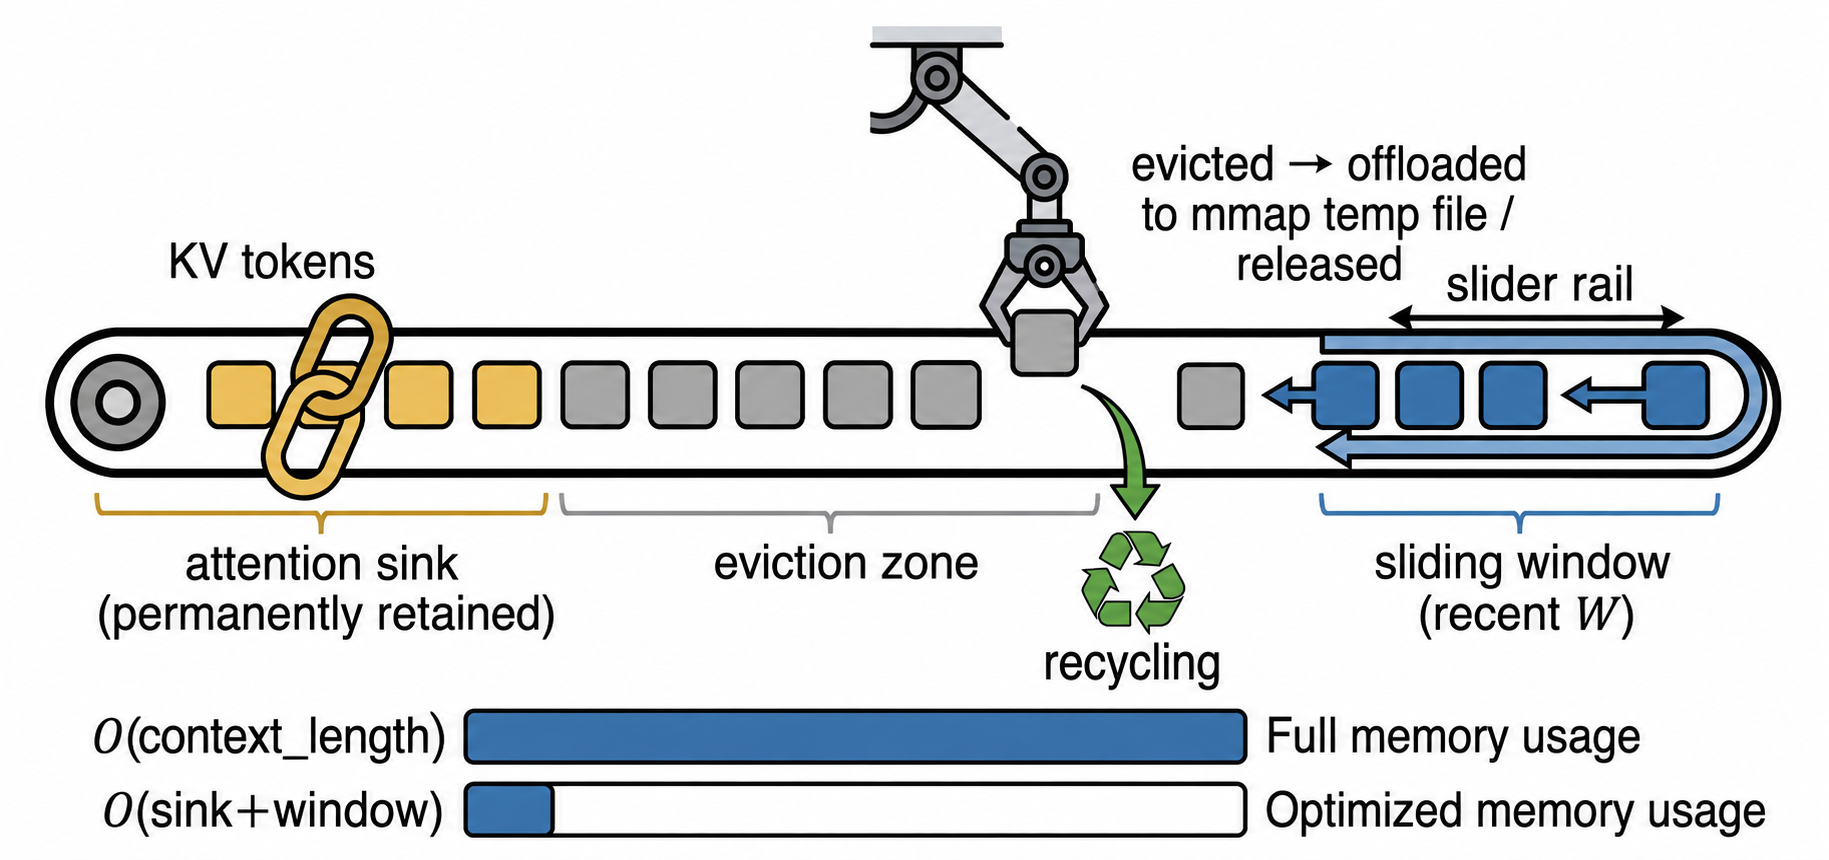
Attention sink、驱逐区和滑动窗口构成的 KV cache 有界管理示意图
KV cache 采用 attention sink 与 recent window;被驱逐页可以释放或转入 mmap 临时文件。
保留

阶段化页建议

RK3588 上静态 RANDOM 只有 0.44/0.26 tok/s;动态 SEQUENTIAL 恢复到 2.84/1.40。

保留

慢盘 shared/hot 驻留

Pi 5 上将容量留给确定复用页,比盲目扩大专家预测更有效。

拒绝

无条件组合优化

Mac 正式矩阵中 combined cold wall 回退 19.95%;局部正确不等于端到端更快。

拒绝

把命中率当作终点

popular-16 增加 I/O、降低命中;cross-layer 高命中也必须支付额外 gate 计算。

05 / LOW-OVERHEAD EXTENSION

面向端侧推理的 Agent Harness

在主运行时之外,SLIM-ARC 提供最小 shell harness:压缩上下文、限制输出预算、记录工具调用,并把超时和失败归一化为可复现实验事件。它用于验证“运行大模型”之外的真实工作负载,而不改变核心推理路径。
短上下文模板输出预算Shell allowlist结构化轨迹
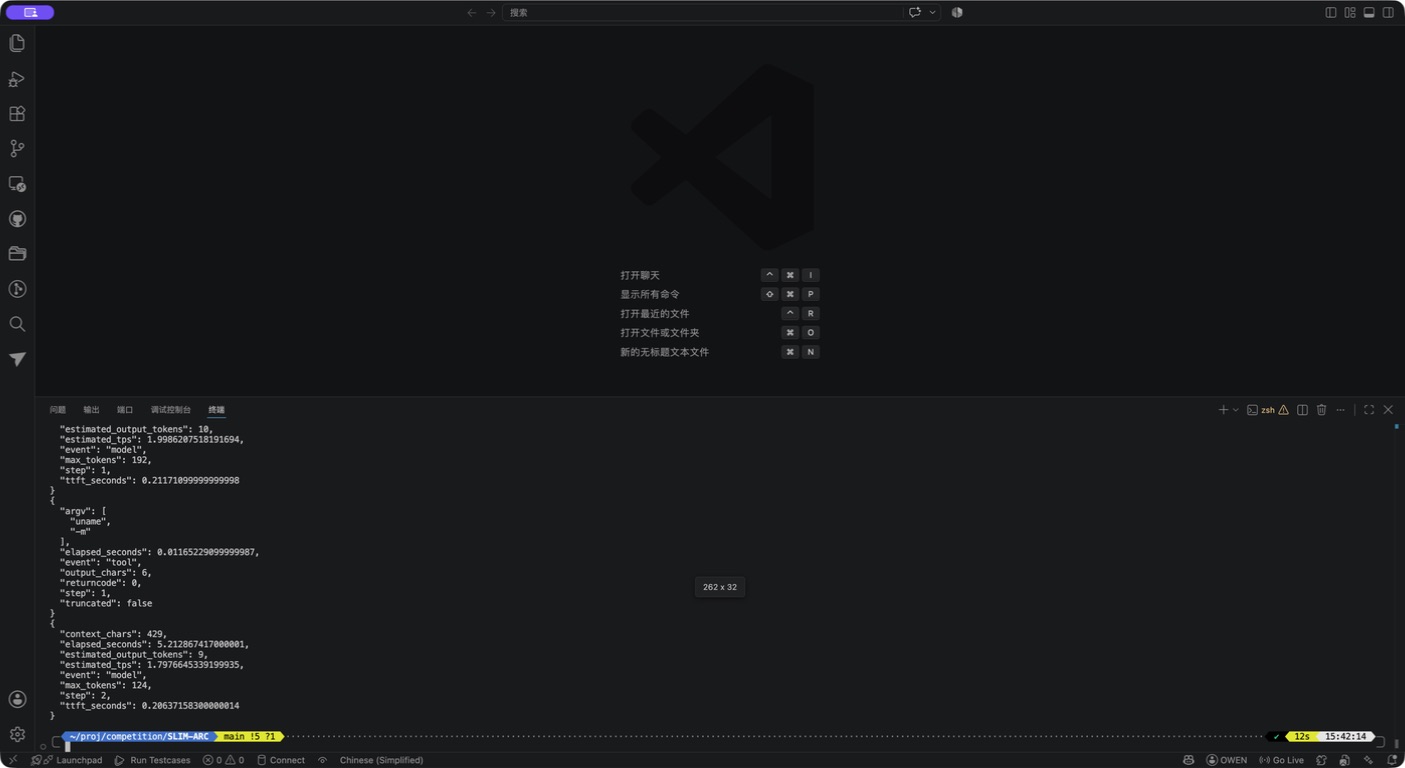
SLIM-ARC Agent Harness shell 任务执行截图
最小化 harness 的本地 smoke 记录;该扩展在报告中作为低开销应用层验证。

06 / WATCH THE SYSTEM

从项目简介到决赛答辩

两个视频分别介绍 SLIM-ARC 的问题背景、系统机制与最终跨设备实验。可直接在页面内播放,也可跳转至 B 站观看。

INTRODUCTION

我们让 800 亿参数 AI 在手机大小的内存里跑起来

在 B 站打开 ↗
FINAL DEFENSE

让 80 亿参数大模型在 2 GB 内存中跑起来|答辩展示

在 B 站打开 ↗

07 / READ THE SYSTEM

从研究动机到跨设备证据

最终报告按照系统论文结构完整呈现背景、相关工作、动机、系统设计、工程实现、实验评估、边界分析与原始数据附录。

01
引言与核心贡献
02
背景、相关工作与动机
03
SLIM-ARC 系统设计
04
系统实现与硬件特化
05
实验评估与结果分析
06–08
结论、附录与引用